Agentes de IA aceleram criação de algoritmos, mas ainda exigem supervisão humana
Anthropic mede avanço de Claude em tarefas de pesquisa, enquanto AlphaEvolve automatiza ciclos de código, teste e seleção de soluções.
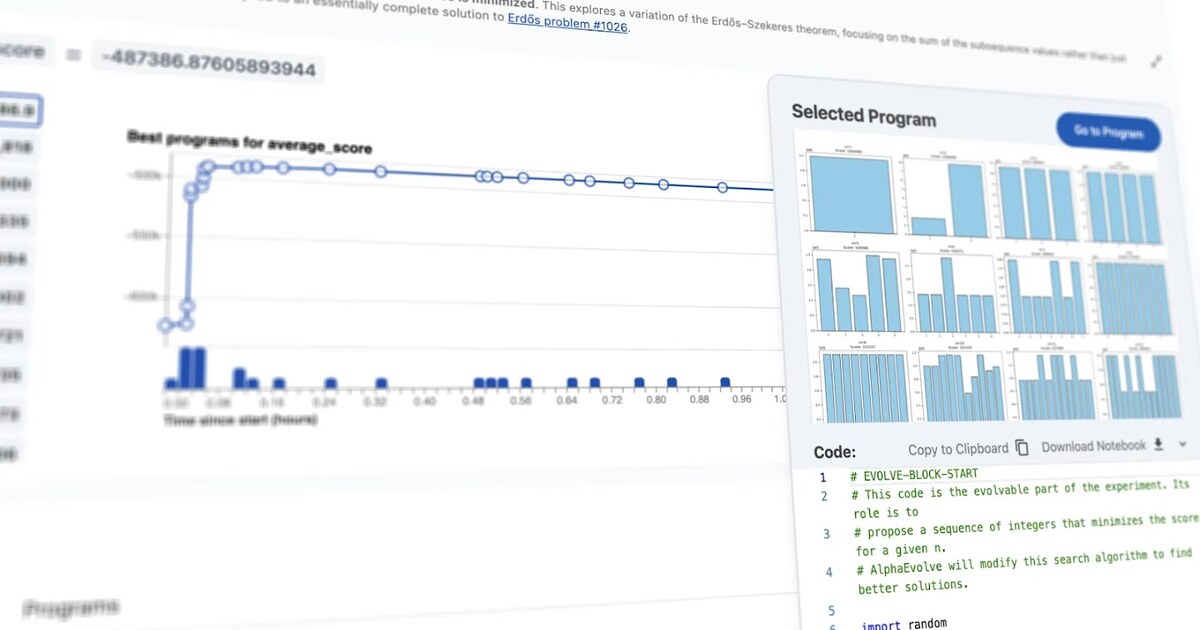
Agentes de inteligência artificial já participam da criação de algoritmos, da escrita de código e da otimização de infraestrutura usada por outros sistemas de IA, mas os exemplos documentados ainda dependem de objetivos, testes e supervisão humana. Anthropic e Google DeepMind apresentaram medições e ferramentas que mostram avanço rápido sem comprovar uma máquina capaz de desenvolver sozinha sua sucessora.
O AlphaEvolve, do Google DeepMind, combina modelos Gemini com avaliadores automáticos. O agente gera programas, executa testes, compara desempenho e usa as soluções mais promissoras como ponto de partida para novas tentativas. Essa estrutura transforma parte da pesquisa de algoritmos em um ciclo computacional repetível.
A Anthropic, por sua vez, criou um índice interno para medir a participação de Claude em tarefas de pesquisa e desenvolvimento. A empresa afirmou que o modelo liderava 26% das tarefas avaliadas em agosto de 2026, contra menos de 1% em fevereiro. O número é relevante, mas deriva de metodologia própria e não representa toda a indústria.
Automação avança do código para o experimento
Assistentes de programação começaram sugerindo linhas e funções. Os agentes atuais podem alterar arquivos, executar testes, analisar falhas e repetir a tentativa. O desenvolvedor passa a definir o objetivo e os limites, enquanto a máquina executa uma sequência maior de decisões sobre como chegar ao resultado.
O AlphaEvolve foi usado para explorar problemas matemáticos, otimizar algoritmos e melhorar componentes da infraestrutura do Google. A empresa relata aplicações em desenho de chips, políticas de cache e sistemas distribuídos. Em julho de 2026, o produto tornou-se disponível de forma geral no Google Cloud para problemas de descoberta e otimização.
O ganho principal pode estar na velocidade. Um pesquisador consegue testar poucas hipóteses manualmente; um agente com avaliação automatizada pode examinar milhares de variações. Isso não garante descoberta útil, mas aumenta o espaço explorado quando a função de avaliação mede corretamente aquilo que importa.
Avaliar continua sendo o ponto crítico
Uma IA pode declarar que melhorou um algoritmo e ainda estar errada. O teste precisa comparar tempo, memória, precisão, segurança e comportamento em cenários que não participaram da geração. Quando o próprio modelo também avalia a resposta, cresce o risco de reproduzir a mesma falha de raciocínio nas duas etapas.
Por isso, ambientes sérios combinam métricas objetivas, testes independentes, revisão de código, isolamento e aprovação humana. Também limitam permissões. Um agente autorizado apenas a propor um trecho de código oferece risco diferente de outro capaz de alterar repositórios, acessar credenciais e publicar diretamente em produção.
Ataques de prompt injection acrescentam outra camada. Um conteúdo externo pode carregar instruções maliciosas que tentam desviar o agente. Se o sistema tiver acesso a arquivos e ferramentas reais, uma resposta manipulada pode produzir ação concreta. Controle de acesso, registros de auditoria e mecanismos de reversão tornam-se indispensáveis.
Desenvolvedor vira coordenador e revisor
A mudança não elimina o trabalho humano; desloca parte dele. Arquitetura, definição de requisitos, seleção de dados, desenho de testes, interpretação de métricas e responsabilidade pelo resultado ganham peso. Escrever código continua relevante, mas saber verificar código gerado passa a ser uma competência central.
Equipes também podem trabalhar com múltiplos agentes: um planeja, outro implementa, um terceiro testa segurança e outro documenta. O arranjo aumenta a produção, mas exige coordenação para impedir alterações incompatíveis ou conclusões divergentes. Quanto maior o número de agentes, mais importante fica a governança do fluxo.
O cenário atual é de aceleração supervisionada, não de autoaperfeiçoamento autônomo ilimitado. A IA já ajuda a construir ferramentas de IA e pode encurtar ciclos de pesquisa, porém pessoas ainda escolhem o problema, definem critérios, controlam acesso e respondem pelas consequências. O próximo avanço deverá ser medido tanto pela capacidade quanto pela confiabilidade.
O AlphaEvolve não é um chatbot de uso geral. A ferramenta foi desenhada para problemas nos quais uma solução pode ser executada e pontuada por critérios objetivos, como otimização combinatória e descoberta de algoritmos. Esse limite explica por que o método funciona melhor quando existe um avaliador automático confiável; tarefas subjetivas ou mal definidas continuam muito mais difíceis de automatizar com segurança.
Em resumo
Não. Sistemas atuais participam de etapas de código, experimentação e otimização, mas dependem de objetivos, avaliação e supervisão humana.
É um agente de programação do Google DeepMind que combina modelos Gemini, avaliadores automáticos e seleção evolucionária de soluções.
A empresa afirma que Claude já lidera parte de suas tarefas internas de pesquisa e desenvolvimento, segundo métrica própria.
Ela permite executar e comparar muitas alternativas, mas os critérios precisam ser confiáveis para não premiar uma solução errada.
Erros em escala, acesso excessivo, prompt injection, alterações indevidas e conclusões não verificadas.
O trabalho tende a incluir mais definição de objetivos, arquitetura, revisão, segurança, testes e coordenação de agentes.